Ժամանակակից ձեռնարկատիրական տվյալների աշխարհում «ճշմարտության միակ աղբյուր» (single source of truth) հասկացությունը հաճախ ավելի շատ ցանկալի նպատակ է, քան իրականություն։ Շատ կազմակերպությունների համար թվային փոխակերպման (digital transformation) «կեղտոտ գաղտնիքն» այն է, որ իրենց կարևորագույն տվյալների շտեմարանները լցված են «ուրվականներով»։ Անկախ նրանից՝ մատակարարը նշված է որպես «Global Tech Solutions», «Global Tech Inc.», «GTS», թե «Global Tech Sols», այս տարբերակները ոչ միայն նյարդայնացնող են, այլև գործառնական արդյունավետության համար կառուցվածքային խոչընդոտներ են։
Ոլորտն արդեն տարիներ շարունակ փորձում է հասնել «ոչ հստակ համընկնումների» (fuzzy matching) որոնմանը՝ որպես այս խնդրի հրաշագործ լուծում։ Մենք ապավինում ենք ալգորիթմների, որոնք գեներացնում են նմանության գործակիցներ՝ հուսալով, որ 91% համընկնման շեմը ճիշտ կմիավորի մեր գրառումները։ Այնուամենայնիվ, ցանկացած տվյալների ինժեներ, որը շաբաթ-կիրակի օրերն անցկացրել է ձեռքով ուղղելով ձախողված միավորումները, կասի ձեզ, որ 91% ցուցանիշը հաճախ թակարդ է։ Դա հավանականային ենթադրություն է, որը հաճախ քողարկում է դետերմինիստական (որոշակի) իրականությունը։ Մինչ մենք անցում ենք կատարում դեպի AI գործակալների (AI Agents) և ինքնավար բիզնես գործընթացների դարաշրջան, «մոտավորապես ճիշտ» համընկնումների հանդեպ մեր հանդուրժողականությունը հասնում է իր սահմանագծին։
Հավանականային դեդուպլիկացիայի սխալը
Երբ մենք խոսում ենք տվյալների դեդուպլիկացիայի (կրկնօրինակների հեռացման) մասին լայն մասշտաբով, ավանդական մոտեցումը ներառում է Լևենշտեյնի հեռավորությունը (Levenshtein Distance) կամ Ժակարի նմանությունը (Jaccard Similarity): Այս չափանիշները քանակականացնում են, թե քանի խմբագրում է անհրաժեշտ՝ մեկ տողը մյուսի վերածելու համար: Դրանք տեսականորեն էլեգանտ են, սակայն գործնականում՝ փխրուն:
Հիմնական խնդիրն այն է, որ նմանության գործակիցները համատեքստ չունեն: 91 նմանության գործակիցը կարող է ճիշտ կապել ընկերության անվան երկու տարբերակ, բայց կարող է նաև պատահաբար միավորել երկու լիովին տարբեր դուստր ձեռնարկությունների միայն այն պատճառով, որ նրանց անուններում կան նույնական հիմնաբառեր: Երբ դուք սա կիրառում եք 10,000 կամ 100,000 գրառումների վրա, սխալվելու հավանականությունն աճում է երկրաչափական պրոգրեսիայով:
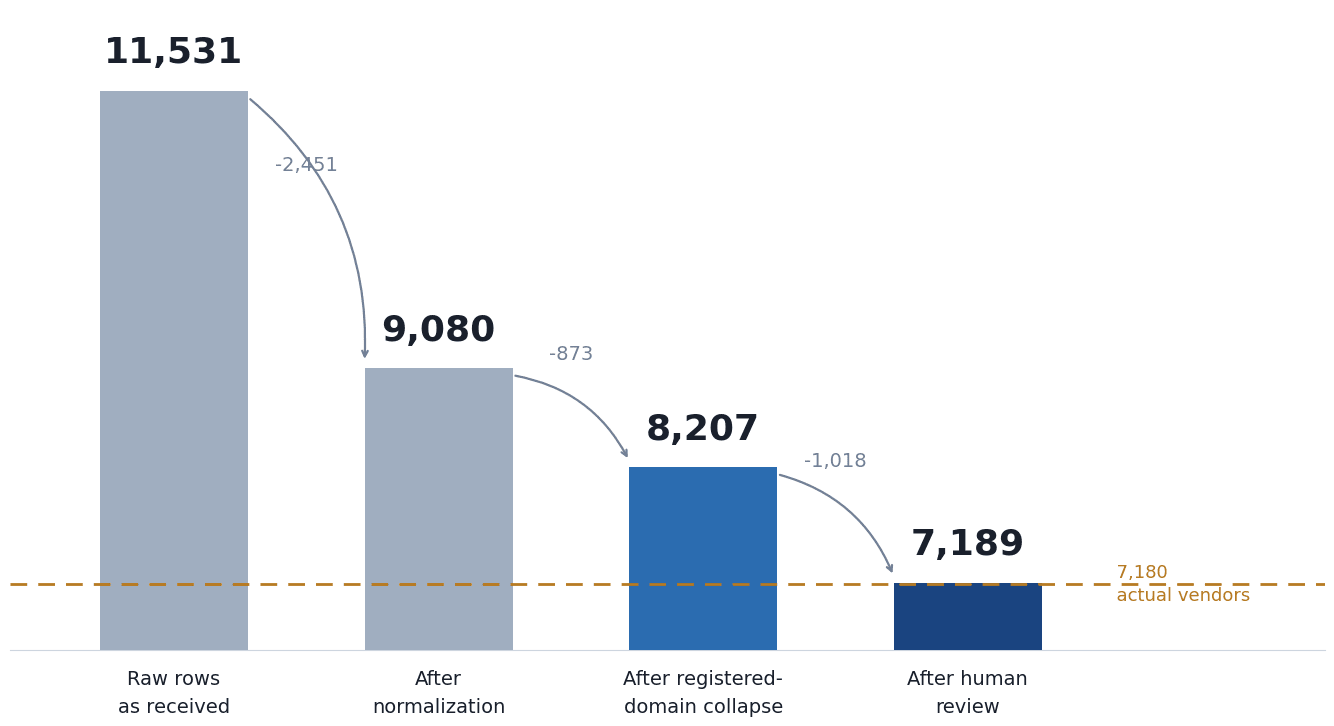
Այստեղ է, որ ոլորտում տեղի է ունենում պարադիգմային տեղաշարժ. հեռացում «ամեն ինչի համար գործակից հաշվելու» մտածելակերպից դեպի դետերմինիստական փուլայնացում (Deterministic Staging): Ալգորիթմին «գուշակելու» հնարավորություն տալու փոխարեն՝ մենք կիրառում ենք կանոնների վրա հիմնված ֆիլտրերի շարք, որոնք հեռացնում են աղմուկը նախքան որևէ նմանության գնահատումը: Բազմաշերտ խողովակաշարի (pipeline) ներդրմամբ կազմակերպությունները կարող են կիրառել նորմալացման խիստ կանոններ՝ օրինակ՝ իրավաբանական անձանց վերջածանցների ստանդարտացում (օրինակ՝ «LLC», «Ltd» և «Corp»-ը միասնական ձևաչափի բերելը) կամ հայտնի հապավումների քարտեզագրում դրանց հիմնական ձևերին՝ նախքան ծանր հավանականային տրամաբանության՝ տվյալներին դիպչելը:
Ինչո՞ւ են դետերմինիստական խողովակաշարերը մեծացնում ROI-ն
Բիզնես ղեկավարների համար տվյալների կրկնօրինակման արժեքը միայն պահեստավորումը չէ: Դա այն շփումն է, որը տարածվում է ամբողջ CRM (Հաճախորդների հետ հարաբերությունների կառավարում) էկոհամակարգում և մատակարարման շղթայում: Երբ AI գործակալին հանձնարարվում է հաշտեցնել հաշիվ-ապրանքագրերը կամ կանխատեսել գնումների կարիքները, նրան անհրաժեշտ են բարձր հավաստիության տվյալներ: Եթե համակարգը վաճառողի անվան չորս գրելաձևը ընկալում է որպես չորս առանձին սուբյեկտ, ապա հետևանքները լուրջ են.
- Ծախսերի վերլուծության մասնատվածություն. Դուք չեք կարող բանակցել զեղչերի շուրջ, եթե ձեր համակարգը կարծում է, որ ձեր ծախսերը բաշխված են տասը վաճառողների միջև՝ մեկի փոխարեն:
- Հաճախորդների փորձի բացեր. Հաճախորդը, ստանալով ավելորդ շուկայագիտական հաղորդագրություններ կամ հակասական տեղեկություններ հաշվի մասին, ընկերությունը ընկալում է որպես մասնատված և ոչ կոմպետենտ:
- Ավտոմատացման ձախողված շղթաներ. Եթե ձեր Ավտոմատացման աշխատանքային հոսքերը գործարկվում են գրառումների թարմացումներով, «կեղտոտ» տվյալները կհանգեցնեն բոտերի սխալ աշխատանքին կամ կանգառին, ինչը կպահանջի թանկարժեք մարդկային միջամտություն՝ սխալների մատյանները շտկելու համար:
Տվյալների մաքրման դետերմինիստական մոտեցում որդեգրելը չի նշանակում հրաժարվել առաջադեմ AI-ից. դա նշանակում է հնարավորություն տալ դրան: Տվյալները դետերմինիստական փուլերով նախապես մշակելով՝ դուք հեռացնում եք «աղբը», որը ստիպում է ձեր մեքենայական ուսուցման մոդելներին սխալվել (hallucinate) կամ թերարժեք աշխատել: Այս անցումը ոչ միայն տեխնիկական նախապատվություն է, այլ նախապայման՝ թվային փոխակերպման նախաձեռնություններից ներդրումների բարձր եկամտաբերություն (ROI) ստանալու համար:
Ապագայի ապահովում ճարտարապետական խստությամբ
Քանի որ ընկերությունները ներդնում են ավելի բարդ Պատվերով ծրագրային լուծումներ (Custom Software)՝ ներքին աշխատանքային հոսքերը կառավարելու համար, այս խողովակաշարերի նախագծումը դառնում է մրցակցային առավելություն: Միտումը տանում է դեպի «մարդը՝ օղակում» (human-in-the-loop) դետերմինիստական փուլայնացման: Այս մոդելում ծրագրակազմը դետերմինիստական կանոնների միջոցով բացահայտում է բարձր վստահելիության համընկնումները, մինչդեռ երկիմաստ դեպքերը նշագրում է մարդկային վերանայման կամ առաջադեմ Խոշոր լեզվական մոդելների (LLM) ստուգման համար:
Այս մոտեցումը ընկեր